Warum ITIL-Erfahrung heute mehr zählt als ITIL-Wissen
ITIL gibt eine Richtung vor, keine Anweisungen. Warum Urteilsvermögen statt auswendig gelernter Prozesse die Praktiken für Incident, Problem und Change zum Funktionieren bringt und warum das mit ITIL (Version 5) noch wichtiger wird.
ITIL war nie dazu gedacht, ohne Nachdenken befolgt zu werden. Es gibt eine Richtung vor, keine Anweisungen.
Die meisten IT-Fachleute können den Unterschied zwischen einem Incident und einem Problem aufsagen. Weit weniger können Ihnen um 2 Uhr nachts, wenn ein ganzes Filialnetz offline ist, sagen, an welchem der beiden sie gerade arbeiten sollten. In dieser Lücke zwischen dem Kennen des Frameworks und seiner Anwendung wird Servicequalität gewonnen oder verloren.
Warum „heute“?
Ältere ITIL-Versionen waren um definierte Prozesse herum aufgebaut. Im Prinzip konnte man ihnen Schritt für Schritt folgen.
ITIL 4 ersetzte Prozesse durch Praktiken, Leitprinzipien und Wertströme. ITIL (Version 5) geht weiter: Transformation steckt jetzt in jeder Designation, und der Schwerpunkt hat sich vom guten Betreiben der Praktiken hin zum Führen von Veränderung durch sie verschoben.
Ein Framework, das auf Prinzipien beruht, lässt sich nicht wie eine Checkliste abarbeiten. Jemand muss entscheiden, wie jedes Prinzip auf diese Organisation, diesen Service und dieses Risiko anzuwenden ist. Diese Entscheidung ist Urteilsvermögen, und Urteilsvermögen kommt aus Erfahrung.
Leitlinien, keine Checkliste
ITIL hilft Organisationen zu verstehen, wie Services Wert schaffen, bessere Entscheidungen zu treffen und sich kontinuierlich zu verbessern. Es erwartet nicht, dass ein Krankenhaus, ein Einzelhändler und eine Reederei Change oder Incident Management auf dieselbe Weise betreiben.
Das Zertifikat beweist, dass Sie die Leitlinien kennen. Erfahrung heißt zu wissen, welche Teile davon an einem bestimmten Dienstag am meisten zählen.
Jeder Service braucht einen Service Owner
„Der Service gehört der IT“ heißt: Er gehört niemandem.
Jeder Service braucht einen einzigen Service Owner: eine namentlich benannte Person, die von Anfang bis Ende für seine Leistung verantwortlich ist, einschließlich der Teile, die andere Teams und Lieferanten erbringen. Der Service Owner behebt nicht jeden Fehler selbst. Er sorgt dafür, dass Fehler behoben, Verbesserungen finanziert werden und jemand für das Ergebnis geradesteht.
Hier ist der Test. Die Gehaltsabrechnung verfehlt ihr SLA, weil eine Firewall-Änderung des Netzwerkteams fehlgeschlagen ist. Wer erklärt das dem CFO? Wenn drei Teams aufeinander zeigen, hat der Service keinen Owner. Der Service Owner ist die Person, die den Anruf bekommt und danach dafür sorgt, dass die nächste Firewall-Änderung der Gehaltsabrechnung nicht wieder schadet.
Erst wiederherstellen, dann die Ursache beseitigen
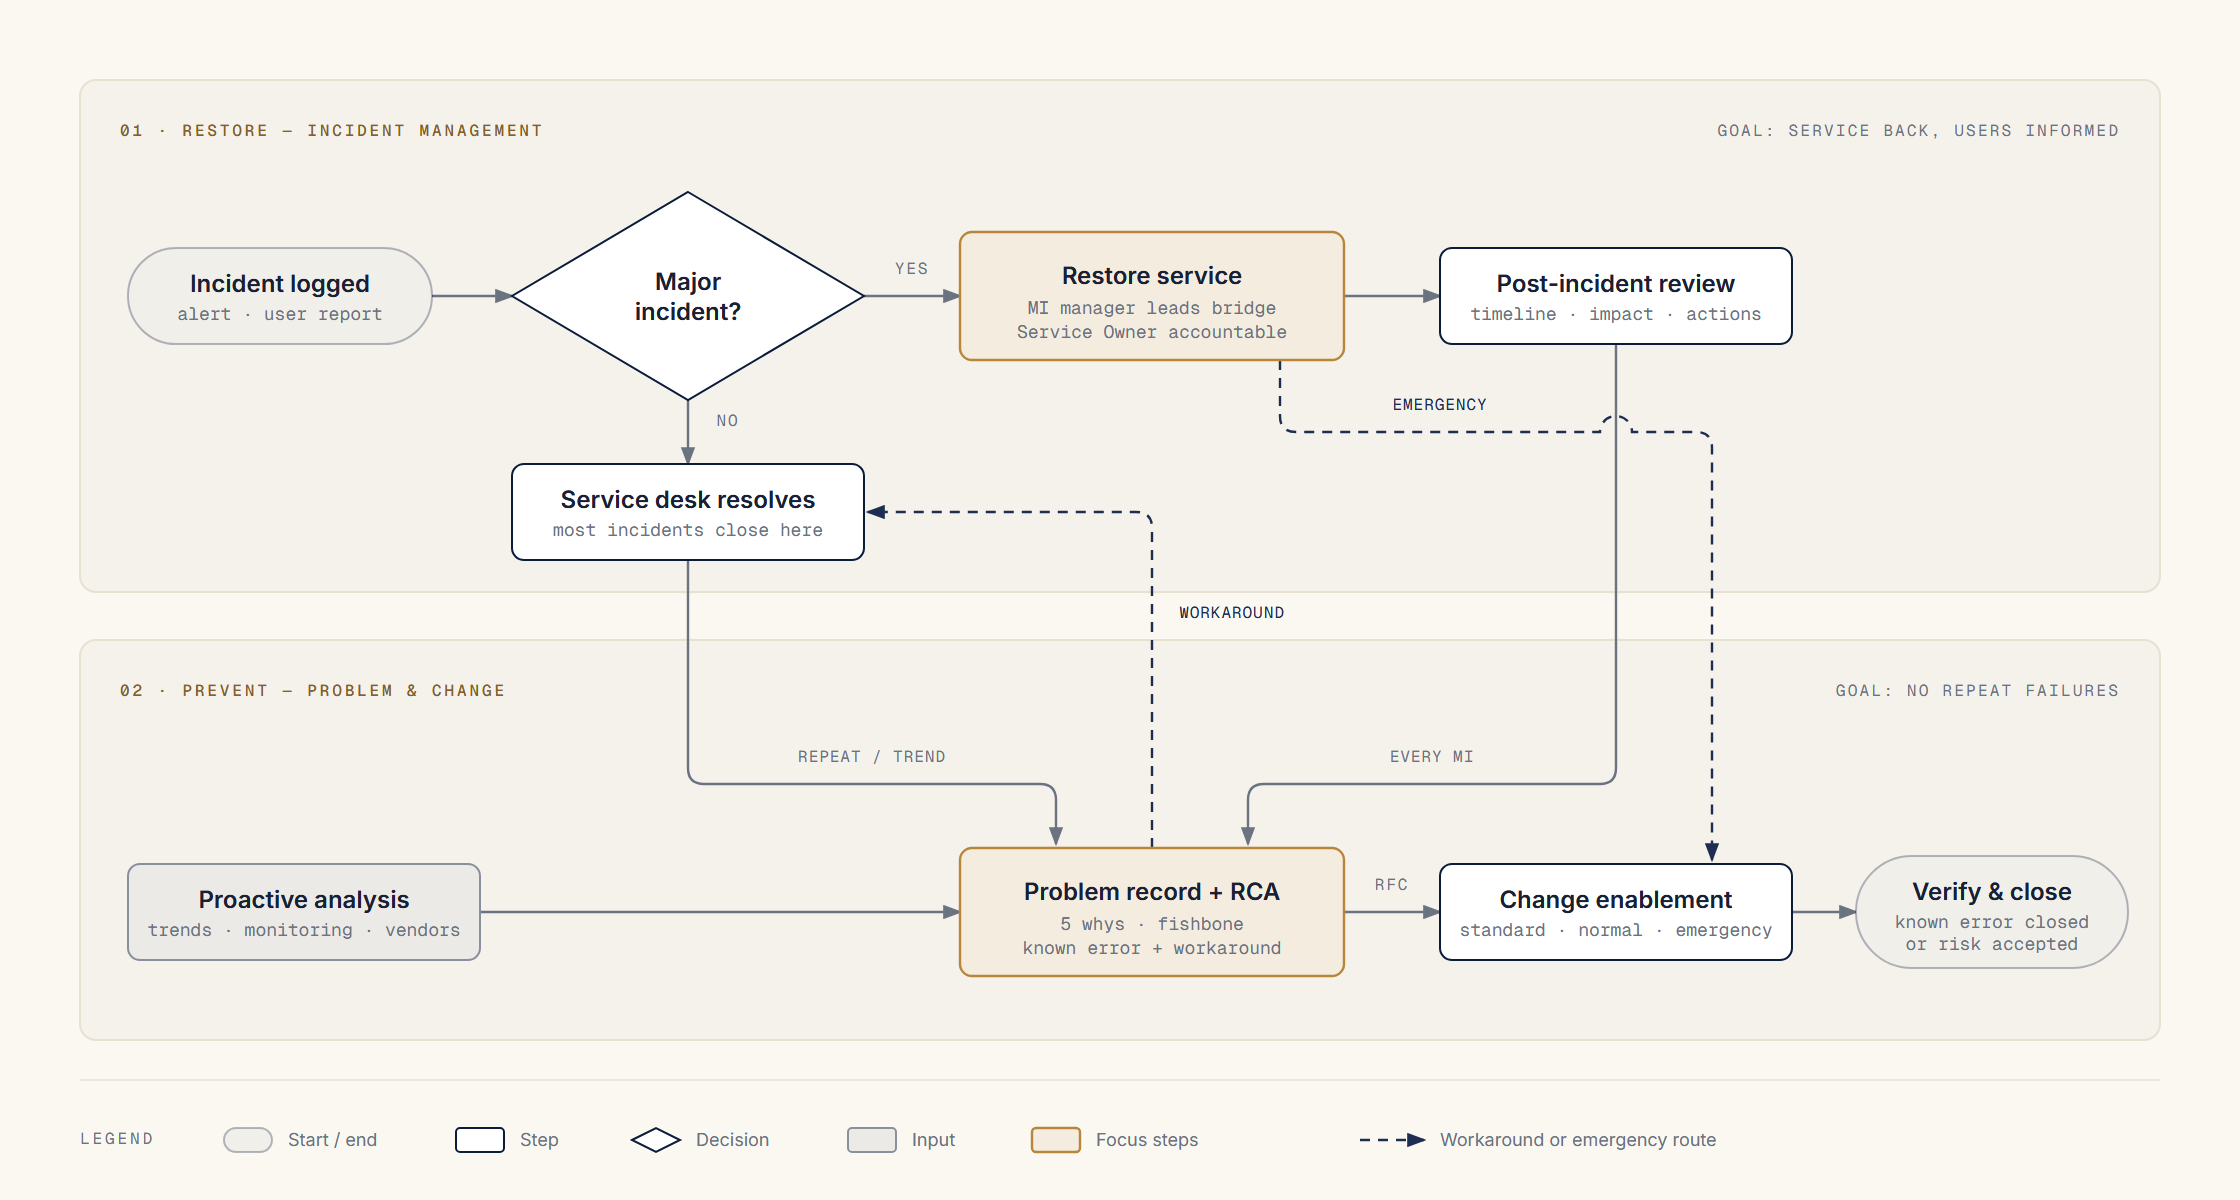
Wenn ein Service ausfällt, ist die erste Aufgabe, ihn wiederherzustellen. Das ist Incident Management, und auf Geschwindigkeit kommt es an.
Der Fehler ist, dort aufzuhören. Fällt die E-Mail dreimal in einer Woche aus, sind das nicht drei unabhängige Incidents. Es sind drei Incidents, die auf ein Problem hinweisen, und bis jemand die zugrunde liegende Ursache findet und beseitigt, ist der vierte Ausfall schon eingeplant.
Die Definitionen zu kennen ist leicht. Erfahrung heißt, das Muster früh zu erkennen, die Disziplin aufzubringen, einen Problem Record zu eröffnen, während alle weitermachen wollen, und die Ursachenanalyse in Maßnahmen mit Verantwortlichen und Terminen zu überführen. Mit strukturiertem Problem Management haben meine Teams wiederkehrende Incidents um 40% reduziert: nicht durch schnelleres Beheben, sondern indem sie dafür sorgten, dass derselbe Fehler nicht zweimal auftreten konnte.
Changes mit dem richtigen Maß an Kontrolle
Veränderung ist normal. Die Kunst besteht darin, die Kontrolle dem Risiko anzupassen.
- Standard Changes sind risikoarm, wiederholbar und vorab autorisiert. Ein Routine-Patch über eine getestete Pipeline sollte nicht auf ein Gremium warten.
- Normal Changes bergen echtes Risiko und brauchen eine Bewertung und Autorisierung, die diesem Risiko angemessen ist.
- Emergency Changes müssen schnell gehen, werden aber trotzdem dokumentiert und überprüft.
Behandeln Sie jeden Change als hochriskant, und die Lieferung kommt zum Stillstand. Behandeln Sie jeden Change als Routine, und irgendwann legt einer das Geschäft lahm. Genau deshalb hat ITIL 4 die Praktik von Change Management in Change Enablement umbenannt: Ziel ist es, Veränderung sicher zu ermöglichen, nicht sie zu verhindern.
Zu entscheiden, in welche Kategorie ein Change gehört, ist eine Ermessensfrage. Eine Regel kann sagen: „Datenbank-Changes sind Normal.“ Nur Erfahrung sagt Ihnen, dass dieser Datenbank-Change an einem Quartalsend-Wochenende einen zweiten Blick verdient.
Verbesserung passiert jeden Tag
Kontinuierliche Verbesserung ist kein Projekt mit Enddatum. Sie findet statt, wenn Teams:
- Kleine Probleme früh erkennen, bevor sie zu Incidents werden
- Praktische Lösungen umsetzen, statt auf ein Transformationsprogramm zu warten
- Die Ergebnisse überprüfen und nachsteuern
Eine gut gepflegte Wissensdatenbank ist ein gutes Beispiel. Sie taucht auf keiner Strategiefolie auf, aber in einer stark ausgelasteten Telekommunikations-Supportumgebung war sie einer der Hauptgründe, warum die Lösungszeiten um 35% sanken.
Was Erfahrung tatsächlich hinzufügt
ITIL-Konzepte zu kennen ist der Ausgangspunkt. Erfahrene Praktiker wissen außerdem:
- Wann man den Leitlinien genau folgt, weil das Risiko hoch ist und der Prozess einen Grund hat
- Wann man sie anpasst, weil buchstabengetreues Befolgen das Geschäft bremsen würde, ohne irgendetwas sicherer zu machen
- Wie man Ergebnisse misst, nicht Aktivität: Services, die verfügbar waren, als das Geschäft sie brauchte, nicht geschlossene Tickets
Diese Balance lässt sich nicht für eine Prüfung auswendig lernen. Sie entsteht, indem man echte Services betreibt, echte Entscheidungen trifft und mit den Folgen lebt.
Fazit
ITIL wurde entwickelt, um gute Entscheidungen zu unterstützen, nicht um sie zu ersetzen. Wer den Zweck hinter den Leitlinien versteht, steuert Services besser, geht souverän mit Veränderung um und verbessert die Qualität fortlaufend.
Am Ende geht es bei ITIL um Menschen und darum, echten Wert zu liefern.
Möchten Sie sehen, wo Ihre eigenen Service-Management-Praktiken stehen? Machen Sie den kostenlosen ITSM-Reifegrad-Check.
Soll das in Ihrer Organisation funktionieren?
Machen Sie den kostenlosen 3-minütigen ITSM-Reifegrad-Check, oder buchen Sie ein 15-minütiges Gespräch, um es zu besprechen.